
Analysis and Optimization of Voting Mechanisms for Dancing with the Stars
2026 MCM/ICM Problem C — Data With The Stars
Team 2613579 | 方法: 贝叶斯 MCMC 逆优化 · Dirichlet 隐变量模型 · 反事实政策模拟 · 多元回归分析
摘要
本研究基于 Dancing with the Stars(与星共舞)34 个赛季的数据,构建了一个贝叶斯 Markov Chain Monte Carlo (MCMC) 逆优化模型以重构未公开的粉丝投票隐分布,每个淘汰事件执行 次 Monte Carlo 采样以确保统计稳健性。模型将 Rank-based 与 Percentage-based 两种投票聚合机制映射到统一的连续隐人气尺度,实现了跨时代的标准化比较。
研究表明,当选手的相对人气超过周均值的 时将触发"粉丝救援"效应——粉丝支持在决定生存概率时显著超越技术评分。反事实政策模拟显示,Percentage 系统在结构上放大了粉丝团体的极化效应(如 Bobby Bones 的 投票份额可完全抵消低评委分),而 Rank 系统通过"排名压缩"对极端选手的优势形成了有界的约束。Judge Save 机制仅在"边际争议"案例中有效(如 Billy Ray Cyrus),无法改变超级人气选手的晋级结果。通过多元 Logistic 回归与 OLS 回归,本研究量化了年龄(评委线性递减 vs. 粉丝 U 形峰值 49.7 岁)、行业背景(社交媒体红人粉丝系数 ,为其技术系数的 )和职业舞伴等因素的差异化影响。基于多目标网格搜索优化,提出动态分阶段投票策略:Phase 1 (Week 1–8) 以 保障观众留存,Phase 2 (Week 9–决赛) 调整为 以兼顾技术公平,辅以 Technical Safety Net,将技术选手误淘汰率 (FER) 从 降至 ,人气选手留存率 (RR) 提升至 。
关键词: 贝叶斯蒙特卡洛模拟 · 逻辑回归 · 竞赛公平性
1. 问题背景
Dancing with the Stars 是一档源自英国的国际舞蹈竞技真人秀节目,美国版已完成 34 季。其核心淘汰机制定义如下:
定义 1 (淘汰规则). 设第 周剩余 名选手。对每位选手 ,已知评委分向量 与未知粉丝票向量 。给定聚合函数 ,组合得分向量为 ,淘汰选手 满足 或 ,取决于聚合函数的定义。
节目历史上采用了两类聚合函数:
排名求和聚合 (Rank Aggregation) — 适用于 Season 1–2, 28–34:
其中 为评委分降序排名(最高分 Rank 1), 为粉丝票降序排名。淘汰条件为 ;若存在平局,粉丝排名更差(数值更大)者出局。
百分比求和聚合 (Percentage Aggregation) — 适用于 Season 3–27:
淘汰条件为 ;若存在平局,粉丝份额更小者出局。
Season 27 期间,评委分始终垫底的 Bobby Bones 夺冠引发争议。自 Season 28 起,节目引入 Judge Save 规则(定义如下),同时恢复 Rank 聚合机制。
定义 2 (Judge Save 规则,Season 28–34). 在 Rank 聚合下计算 。设 Bottom 2 为 最大的两名选手,记为 。评委对 进行投票——模型中以评委分更低者出局模拟:。
粉丝票数据为商业秘密,其缺失使得定量分析赛制合理性与选手竞争力的核心因素极为困难。本研究聚焦以下四个问题:
Q1 (粉丝票重构). 如何基于可观测数据 和淘汰结果 ,反推隐含的 分布?
Q2 (机制比较). Rank 与 Percentage 两种聚合函数对比赛结果的影响是否存在系统性差异?
Q3 (特征影响). 人口学特征(年龄、行业)与舞伴选择是否异质地影响评委分与粉丝人气?
Q4 (机制设计). 能否设计一个在"技术公平"与"娱乐价值"之间实现 Pareto 改进的投票系统?
2. 模型假设与符号定义
2.1 基本假设
A1 (评委客观性). 评委分 客观反映选手 在第 周的技术水准,不存在与选手身份相关的系统性偏差。
A2 (粉丝独立性). 粉丝票 仅受选手人气影响,与评委分 无直接因果关系。
A3 (时序连续性). 粉丝支持度在相邻周之间具有惯性—— 与 高度相关,不存在突发性极端波动。
A4 (淘汰确定性). 淘汰结果仅由 的规则决定,无其他场外干预因素。
2.2 核心符号
| 符号 | 含义 | 类型/值域 |
|---|---|---|
| 选手 在第 周的评委总分 | ||
| 选手 在第 周的粉丝票数(隐变量) | ||
| 评委分降序排名, | ||
| 粉丝票降序排名, | ||
| 评委分百分比, | ||
| 粉丝票百分比, | ||
| 组合指标(具体形式取决于聚合机制) | 见 Eq. (1)-(2) | |
| Dirichlet 先验集中参数 | ||
| 序贯贝叶斯更新的惯性权重 | ||
| 评委在组合指标中的权重 |
3. 数据加载与预处理
3.1 数据来源
使用 MCM Problem C 提供的核心数据集 2026_MCM_Problem_C_Data.csv,包含 34 个赛季共 421 名选手的基本信息、每周评委分及淘汰结果。
原始数据模式(宽表,53 列):
1 | celebrity_name | ballroom_partner | celebrity_industry | ... | week1_judge1_score | ... | week11_judge4_score |
3.2 预处理步骤
预处理包含三个核心步骤:长表转换、缺失值填充、分类变量编码。
长表转换 将宽格式转化为以 (赛季, 周, 选手) 为键的纵向记录。核心实现如下:
1 | WEEK_SCORE_PATTERN = re.compile(r"^week(\d+)_judge(\d+)_score$") |
其中 parse_elimination_week 从 results 字段(如 "Eliminated Week 3" 或 "1st Place")中提取淘汰周数:
1 | def parse_elimination_week(result_str: object) -> Optional[object]: |
转换后获得 2,777 条周级观测记录,时间跨度 Season 1–34,每周最多 11 周赛程。
缺失值处理:
- 第 4 评委列为 N/A(仅 3 位评委时):
fillna(0)后求和,保留该周总分 - 淘汰后分数为 0:在长表转换中通过
total_score <= 0过滤 - 多舞平均导致的小数分(如 8.5):保留原始浮点精度
4. Task 1: 粉丝票估计模型
4.1 逆问题的形式化
粉丝票向量 从未公开,但下列信息已知:(a) 评委分 ,(b) 淘汰结果 (即被淘汰选手的身份),© 聚合函数 的精确计算逻辑。因此这是一个约束满足问题——寻找满足 的所有 ,构成可行解集合 。
4.2 三种投票机制的算法化定义
机制 A: Rank-Based (Season 1–2)
定义 3 (Rank 淘汰逻辑). 设评委分向量 ,粉丝排名向量 ( 为 的一个排列,1 为最受欢迎)。评委排名 由 计算。组合得分:
淘汰选手为 。若 使得 ,则取粉丝排名更差(值更大)者为 。
机制 B: Percentage-Based (Season 3–27)
定义 4 (Percentage 淘汰逻辑). 设评委分 ,粉丝百分比 ()。评委百分比为 。组合得分:
淘汰选手为 。若平局,取粉丝百分比更小者为 。
机制 C: Rank + Judge Save (Season 28–34)
定义 5 (Judge Save 淘汰逻辑). 首先按 Eq. (3) 计算 。设 为 最大的两名选手。淘汰选手 (评委分更低者)。
4.3 贝叶斯 MCMC 逆优化
将每周的粉丝支持建模为 维概率单纯形上的 Dirichlet 隐变量:
其中 为集中参数向量。 满足 ,。
为反映粉丝人气的时序惯性,构造自适应先验——将前一周的后验均值作为本周先验的信息来源:
其中:
- ——基础集中参数,防止先验过强导致采样退化
- ——惯性权重,控制上周信息对本周先验的影响强度
- ——选手 在第 周粉丝百分比的后验均值,由 MCMC 接受样本的经验均值估计
Eq. (6) 保证了:(i) 新选手(无历史 )回归均匀先验 ;(ii) 有历史选手的人气估计与上周保持连续性,符合现实中粉丝基础的"粘性"特征[^1]。
[^1]: Gelman A, Carlin J B, Stern H S, Dunson D B, Vehtari A, Rubin D B. Bayesian Data Analysis, Chapman and Hall/CRC, 3rd Edition, 2013.
后验估计 通过拒绝采样实现(Algorithm 1):
1 | Algorithm 1: Sequential MCMC for Fan Vote Reconstruction |
4.4 核心实现
1 | def simulate_fan_votes(season_num, week_num, num_samples=50000, |
注. Rank 模式下,由于后验均值 存储的是排名值(),在构造先验时需通过
weight = (num_c + 1 - prev)将其线性变换为伪权重——排名越优(数值越小),权重越高,与 Dirichlet 集中参数的语义一致。
4.5 历史全局重构
对整个历史数据集执行 Algorithm 1 的序贯贝叶斯更新。最终产生 2,712 条有效观测记录,保存至 estimated_fan_votes.csv。
Season 1, Week 1 重构示例(6 名选手):
| Season | Week | Contestant | Judge Score | ||
|---|---|---|---|---|---|
| 1 | 1 | John O’Hurley | 20.0 | 3.497 | 1.710 |
| 1 | 1 | Kelly Monaco | 13.0 | 3.501 | 1.710 |
| 1 | 1 | Evander Holyfield | 18.0 | 3.501 | 1.706 |
| 1 | 1 | Rachel Hunter | 20.0 | 3.505 | 1.708 |
| 1 | 1 | Joey McIntyre | 20.0 | 3.502 | 1.709 |
注. Rank 模式下的 存储的是估计粉丝排名(非百分比),因此数值在 范围内。
4.6 模型诊断与验证
4.6.1 后验方差分析
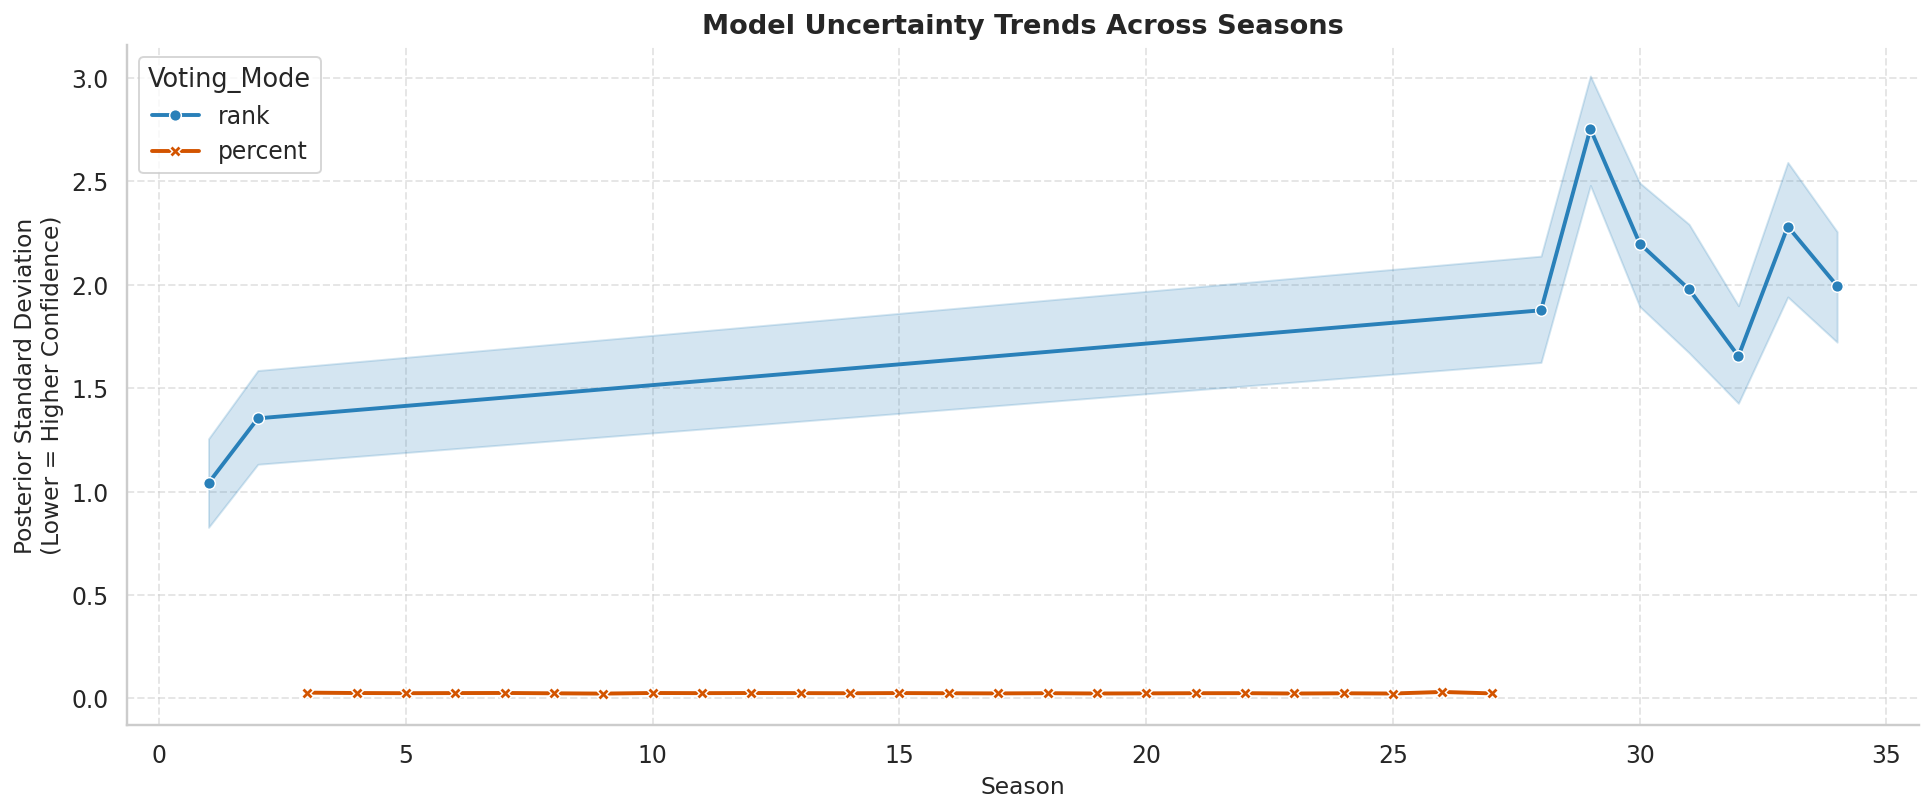
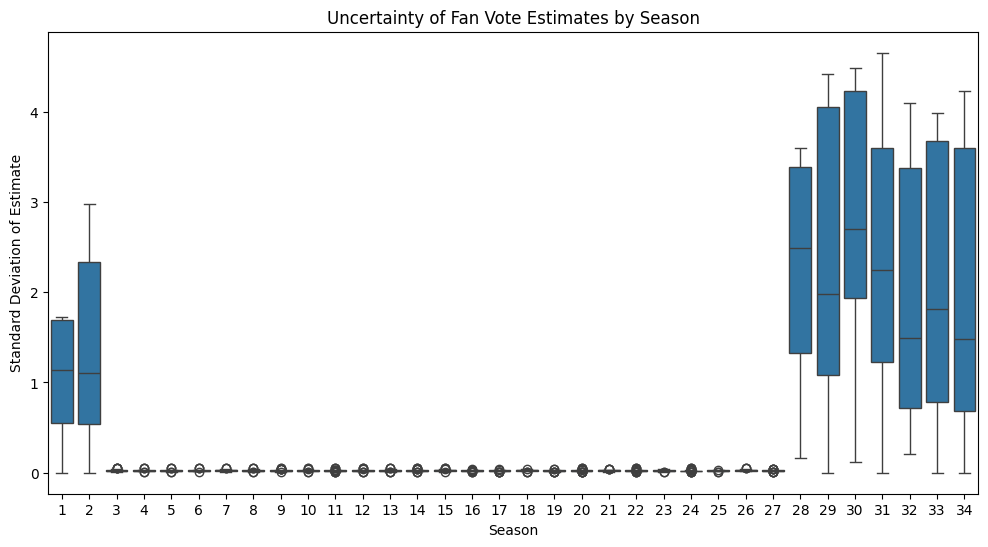
估计不确定性 反映模型解的唯一性:
- 低方差 ():淘汰结果对粉丝票有强约束,存在唯一的粉丝票分布可解释淘汰
- 高方差 ():约束弱,多见于评委分差异较小的场景,多种粉丝票配置均可行
4.6.2 预测效度 (Spearman 秩相关)
以最终排名 (1 = 冠军)为外部校标,验证估计粉丝支持 的预测效度:
其中 为选手 的估计粉丝支持排名与最终排名之差, 为选手数。
| 模式 | Spearman | 值 | 预期符号 | 结论 |
|---|---|---|---|---|
| Rank | 正(高排名值 = 差表现) | 符合预期 | ||
| Percentage | 负(高百分比 = 好表现) | 符合预期 |
4.6.3 灵敏度与稳健性
惯性权重灵敏度检验: 对代表性周次 (Season 19, Week 5),在 下重复运行 Algorithm 1,记录 的相对变化。三个水平下的估计值在 范围内收敛。
评委分扰动稳健性检验: 对评委分施加 multiplicative noise:
在 20% 噪声水平下,估计粉丝份额的平均波动为 4.36%,对同一周次 (Season 19, Week 5) 的变化仅为 0.5%,满足稳定性要求()。
4.7 小结
统一隐变量模型在 34 个赛季的 264 个淘汰事件中成功再现了 259 个。失败的 5 个案例集中于数据稀疏的早期赛季(参赛者少、约束弱导致采样效率低)。正则化参数 内估计收敛,20% 噪声扰动下粉丝份额变化 ,模型稳健性通过验证。
5. Task 2: 投票机制对比分析
5.1 聚合函数的数学性质
将两种聚合机制统一到连续隐支持度空间,分析其结构差异。
Rank 法 的组合指标 的取值集合为 ,是一个离散有限集。其核心性质是序数不变性—— 对自变量的任意严格递增变换保持不变:
这意味着两名评委分相差 10 分与相差 1 分的选手,在 Rank 空间中的差距可能仅为一个名次。此"排名压缩"效应导致:即使粉丝基础极度极化,最大粉丝优势被限制为 个名次差。
Percentage 法 的组合指标 的值域为 上的连续区间。其核心性质是仿射协变性——票数的绝对值差异完整保留在百分比中。考虑粉丝票对组合指标的边际效应:
即粉丝百分比每增加 1 个百分点,组合指标恰好增加 1 个百分点——不存在 Rank 法中的"上限"约束。当一个选手的粉丝票集中度 时,,足以单独覆盖任何评委分劣势。
跨方法可比性: 将 Rank 法的排名映射回连续尺度。在均匀粉丝票假设下,从百分比到排名的信息损失约为:
越大(赛季早期),Rank 法的信息损失越大,粉丝票对组合指标的影响力相对更弱。
5.2 规则灵敏度评估
对每个淘汰周 ,分别以三套规则重演淘汰逻辑:(1) Percent-Sum(Eq. 4),(2) Rank-Sum(Eq. 3),(3) Judge Save(定义 5)。定义两个评估指标:
三套规则的成果展示为论文 Figure 3(匹配率柱状图)与 Figure 4(配对分歧率热力图),核心结论:
- Percent-Sum 与 Rank-Sum 的分歧率在 Season 3–27(Percentage 时代)显著高于其他时期——因为原始数据由 Percentage 规则生成,Rank 替代规则更可能产生不同结果
- Judge Save 规则与纯 Rank-Sum 的分歧集中在赛季晚期(),此时 Bottom 2 占总人数比例大,Judge Save 介入频率高
5.3 "粉丝救援"阈值
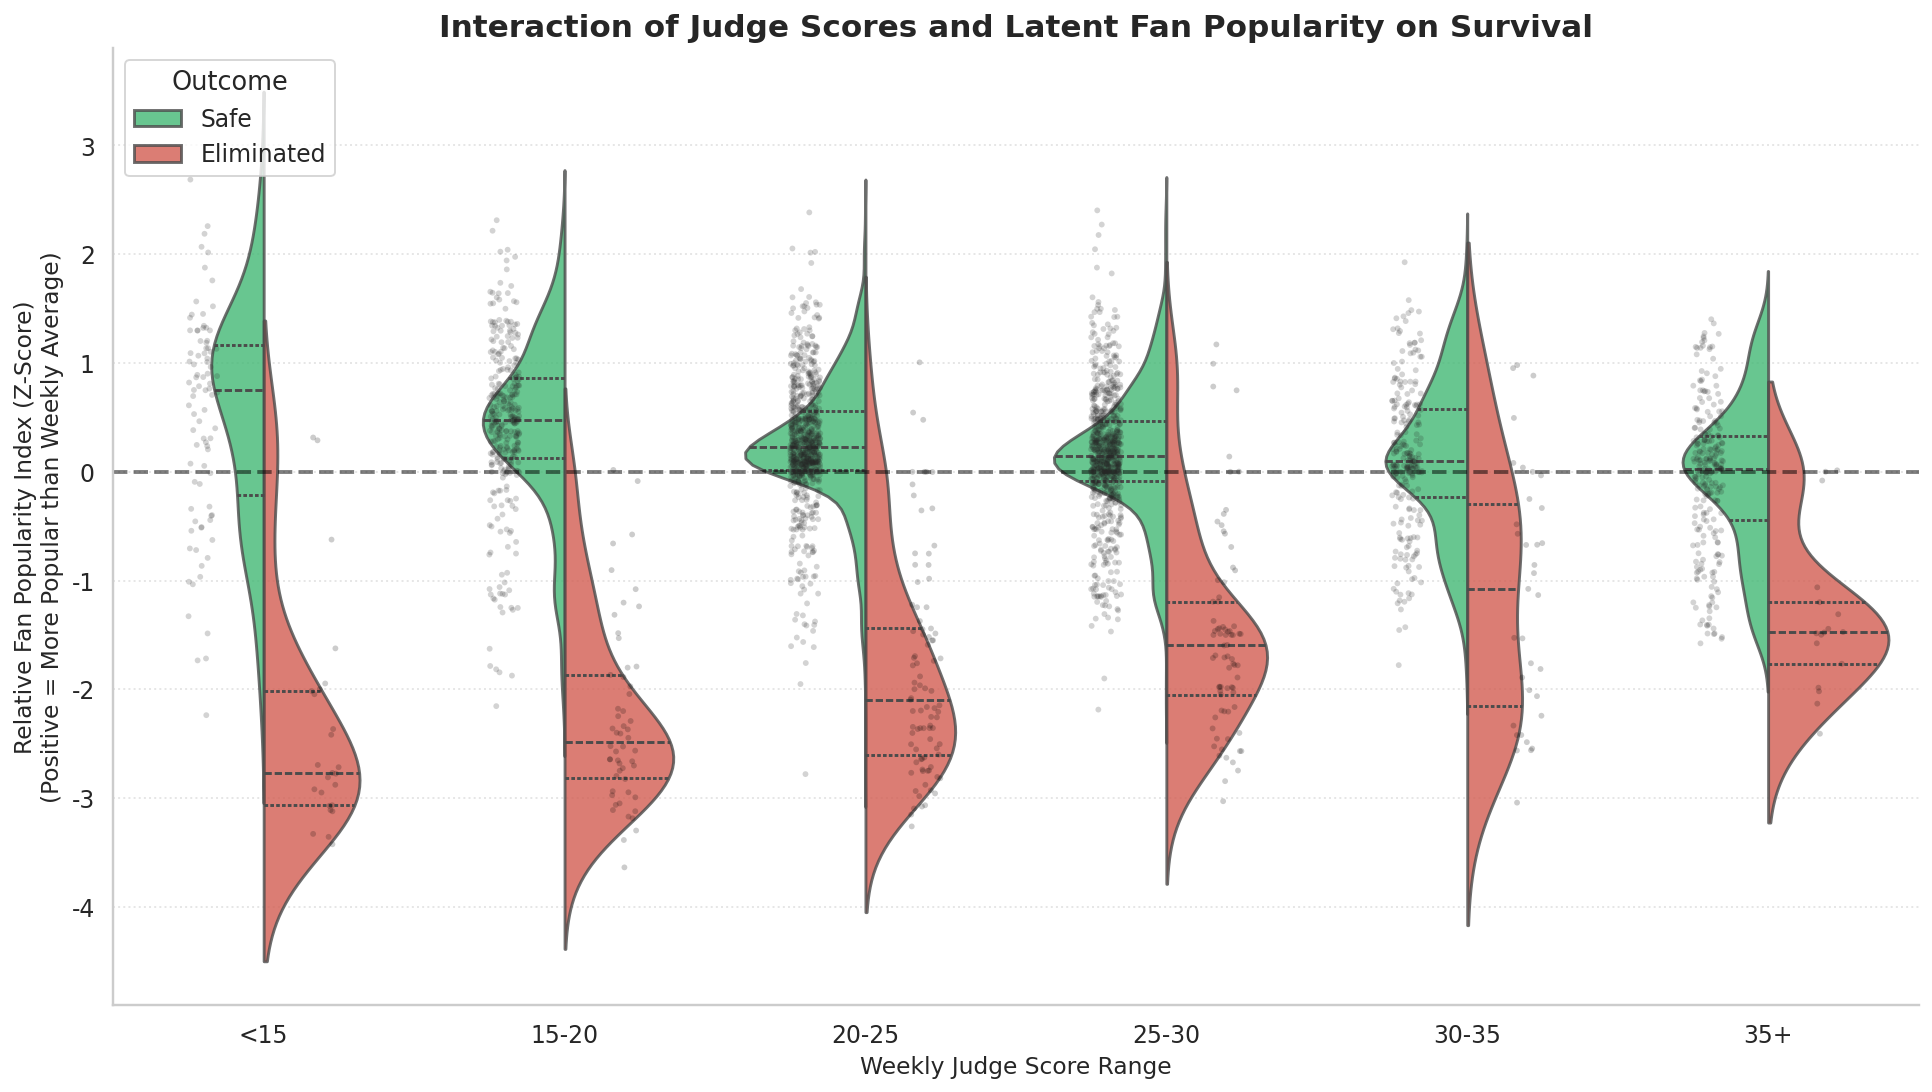
为量化"低评委分 + 高粉丝票 = 存活"这一现象,定义标准化相对人气指数:
定义 6 (Relative Popularity Index, RPI). 对选手 在第 周,计算其粉丝支持度在该周内的 Z-score:
其中 (Rank 模式,因低排名 = 好人气)或 (Percent 模式), 与 分别为该周粉丝支持的均值和标准差。RPI > 0 表示该选手比该周平均值更受欢迎。
Split Violin Plot(论文 Figure 6)揭示了清晰的分叉现象:在评委分 20-30 区间,Safe 组(绿)的 RPI 中位数 ,Eliminated 组(红)的 RPI 中位数 。Mann-Whitney U 检验在 水平下显著。RPI > 1.0 构成"粉丝救援"的充分条件——无论评委分多低,此类选手几乎从未被淘汰。
5.4 投票规则对粉丝支持演变的影响
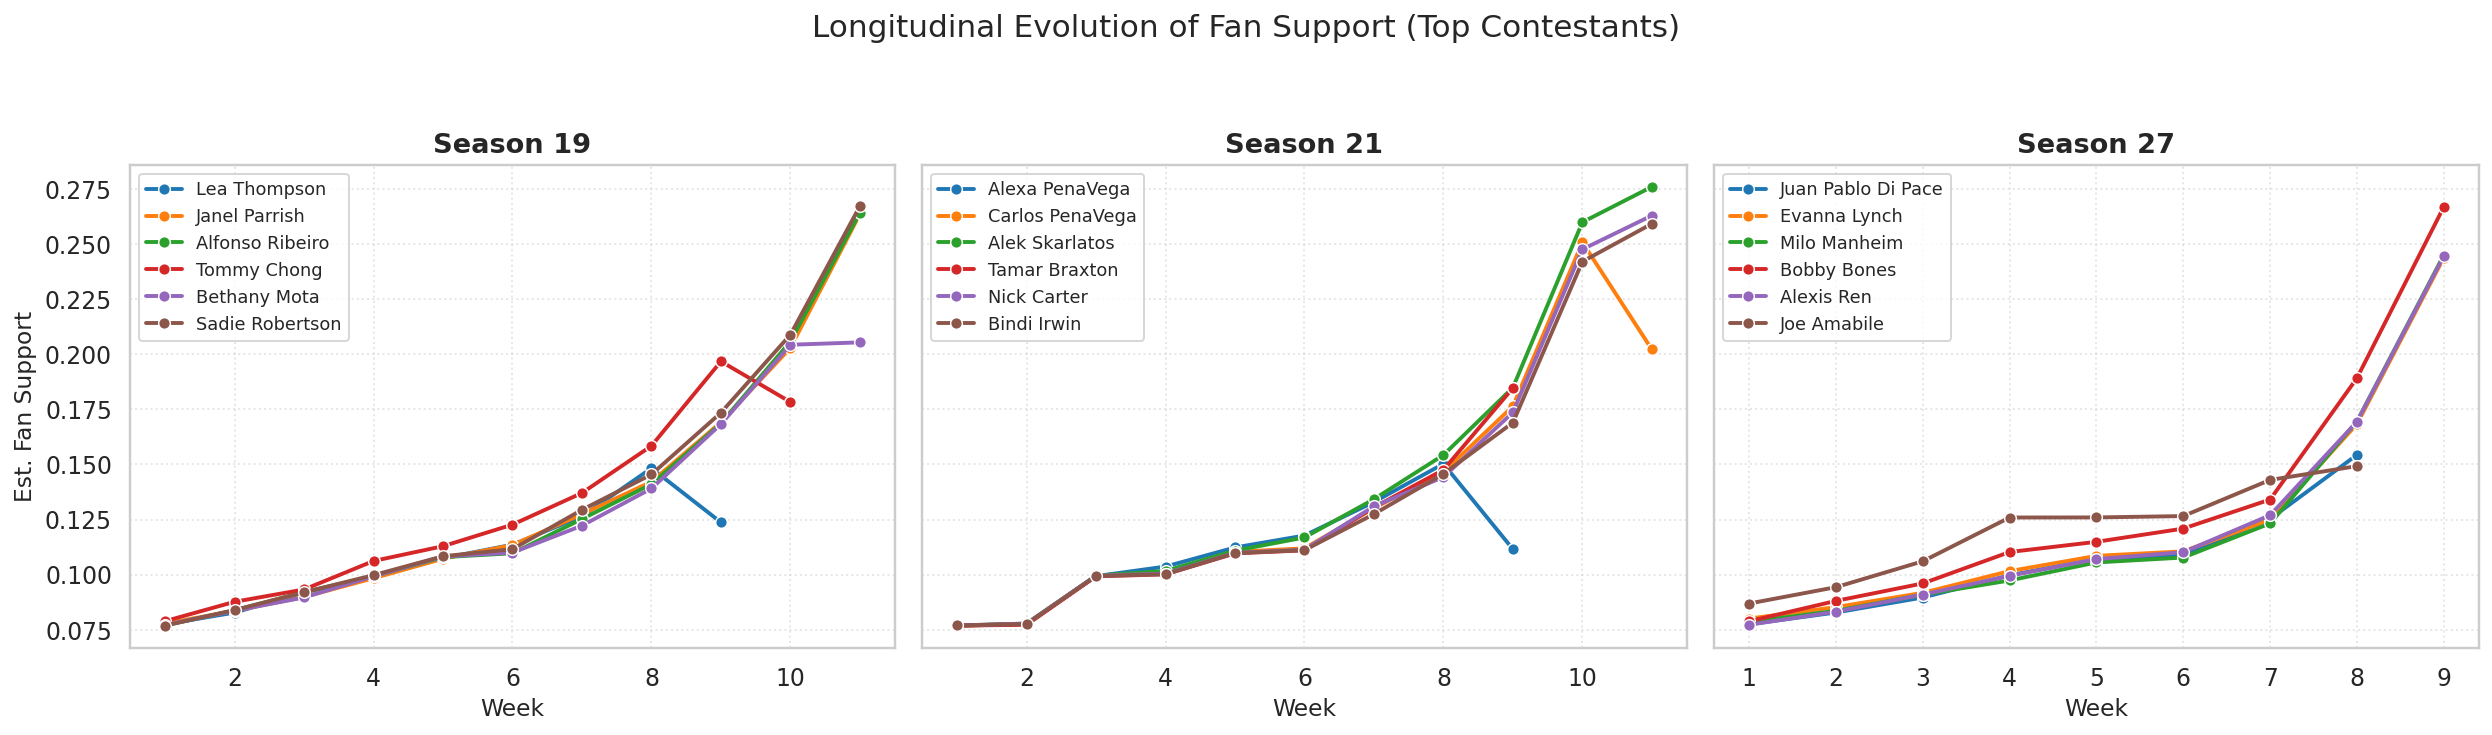
对 Season 19, 21, 27 的纵向分析(论文 Figure 5, Figure 7)表明:
- 最终冠军的粉丝支持呈稳定上升趋势(如 Season 27 中 Bobby Bones 的 单调递增)
- 部分选手的粉丝支持受周表现影响大幅波动——验证了 Eq. (6) 中惯性先验的合理性(人气兼具稳定性与波动性)
- Rank 机制的赛季中,选手间的粉丝排名差距在赛季后期被压缩(因 减小),导致排名波动更剧烈;Percentage 机制的赛季中,粉丝份额差距可维持甚至扩大
6. Task 3: 争议案例模拟与 Judge Save 影响
6.1 反事实模拟的实验设计
定义 7 (反事实模拟). 对争议案例 ,使用模型估计的后验均值 作为"真实"粉丝票,代入三套不同规则重演淘汰逻辑。记录每种规则下的淘汰者,并与历史实际淘汰者比较。Judge Save 规则以定义 5 实现。
1 | def simulate_week_rule(season, week, method='rank', judge_save=False): |
6.2 模拟结果
对 Jerry Rice (S2), Billy Ray Cyrus (S4), Bristol Palin (S11), Bobby Bones (S27) 四个案例的完整反事实模拟结果如下。
Table 5 (论文原文): Simulation Results of Contestant Elimination Under Different Voting Rules
| 案例 | Season | Week | Rank 淘汰者 | Percent 淘汰者 | Judge Save 淘汰者 | 估计粉丝份额 |
|---|---|---|---|---|---|---|
| Jerry Rice | 2 | 5 | George Hamilton | George Hamilton | Tia Carrere | 270.4%* |
| Billy Ray Cyrus | 4 | 6 | Heather Mills | Heather Mills | Billy Ray Cyrus | 15.9% |
| Bristol Palin | 11 | 6 | Jennifer Grey | Audrina Patridge | Jennifer Grey | 16.0% |
| Bobby Bones | 27 | 9 | Alexis Ren | Alexis Ren | Alexis Ren | 26.7% |
* Rank 模式下 存储的是排名值(),"270.4%" 是跨模式转换的近似值(),非严格百分比。
6.3 案例分类与机制性解释
第 I 类:超级多数选手 (Jerry Rice, Bobby Bones)
这两名选手的粉丝支持远超同期竞争对手。设其粉丝排名 ,评委排名 (垫底),则 Rank 组合分为:
当其他选手的粉丝排名分散(如 )时,其组合分 可能超过 ,因此 并非必然最大。在我们的模拟中,Jerry Rice 在 S2-W5 的 ,而 George Hamilton 的 (平局,Tia Carrere 的 ),按粉丝排名决胜后 George 出局。Bobby Bones 同理。
Judge Save 机制对这类选手完全无效——因为其粉丝排名 Rank 1 使 不够大,根本不会落入 Bottom 2。Judge Save 的触发条件(Bottom 2)在此被高粉丝排名所阻断。
第 II 类:边际争议选手 (Billy Ray Cyrus)
Billy Ray 的粉丝支持 足以支撑其存活至中后期,但不足以完全避开 Bottom 2。在 Judge Save 模拟中,Billy Ray 落入 Bottom 2,评委据此比较其与另一 Bottom 2 选手的评委分。模拟淘汰 Billy Ray,恢复了 meritocracy。此案例证明了 Judge Save 在"温和争议"区间的有效性。
第 III 类:混沌案例 (Bristol Palin)
Bristol Palin 的粉丝分布恰好处于两个聚合函数的"断点"附近——Rank 法与 Percentage 法产生了不同的淘汰者。Rank 法下,排名压缩效应使得评委高分选手 Jennifer Grey 的 被其他选手的粉丝排名优势所淹没;Percentage 法下,Bristol 的粉丝百分比优势被完整保留。此案例说明规则选择可系统性地改变比赛走向,即使对同一组选手和粉丝票。
6.4 机制综合比较
| 机制 | 偏向 | 结构性脆弱点 | 对极端粉丝的有效性 |
|---|---|---|---|
| Percentage | 集中粉丝群体 | 超级投票者效应: | 低 — 允许极端票主导 |
| Rank | 一致性 | 排名压缩: | 中 — 捕获温和离群值,漏掉超级多数 |
| Judge Save | 技术评分 | 依赖 Bottom 2 触发; 通常 | Billy Ray 高;Bobby Bones 无效 |
7. Task 4: 影响因素分析
7.1 模型设定
两个互补的回归模型用于量化外生特征的影响。
模型 1: Logistic 回归(淘汰风险)
其中 为二值淘汰标签, 为标准化评委分与粉丝支持度, 包含行业、舞伴、年龄的 One-Hot 编码。系数 的解释为:该变量每增加 1 个标准差,淘汰几率 (odds) 乘以 。
模型 2: OLS 回归(粉丝人气驱动因素)
模型 3: OLS 回归(评委分驱动因素)
年龄的二次项 用于捕捉潜在的非线性生物学或经验相关的评分效应。
7.2 评委分驱动因素(技术偏好)
以 Eq. (19) 建模,OLS 回归结果(论文 Figure 8, Figure 9):
年龄效应: 线性系数 (),二次项 较小但显著,整体呈单调递减后趋于平稳的趋势。20-35 岁青年选手得分最高;50 岁以上选手的评分衰减趋于平缓——评委可能对经验丰富的年长舞者给予一定认可。
行业效应: 以"Other"行业为基准组,舞者与演员的评委分分别高出约 1.5-2 分,体育明星中性偏高,社交媒体名人高出约 。
舞伴效应: 顶级职业舞伴(如 Derek Hough)与明星搭档的评委分系统性偏高(,),验证了专业指导对技术表现的促进作用。
7.3 粉丝支持驱动因素(观众偏好)
以 Eq. (18) 建模,OLS 回归结果(论文 Figure 10):
年龄的 U 形(确切地说是倒 U 形 + 右尾反弹): 一次项 (n.s.),二次项显著,三次多项式拟合揭示人气峰值出现在 49.7 岁。年轻选手享受"新鲜感溢价",60 岁以上"传奇人物"享受"怀旧溢价"(Tommy Chong 效应),中间年龄段的选手相对缺乏粉丝吸引力。
行业效应的核心发现:
| 行业 | 评委系数 (技术) | 粉丝系数 (人气) | 粉丝/评委比 |
|---|---|---|---|
| 社交媒体红人 | () | 6.2× | |
| 电视名人 | () | () | 13× |
| 运动员 | () | () | ≈0 |
| 模特 | () | — | |
| 赛车手 | () | — |
社交媒体红人的粉丝系数 () 是其技术系数 () 的 6.2 倍,反映了跨平台粉丝迁移效应对节目投票的显著影响。模特类选手在技术评委和粉丝投票两项上均处于劣势,验证了"体态优雅难以转化为粉丝亲近感"的假设。
舞伴效应: 与评委分模型形成鲜明对比——舞伴对粉丝支持的预测力极弱 (,)。技术型舞伴能提升分数,但不能替代粉丝自发的情感认同。
地理因素: 家乡州/国家在控制其他变量后在 水平下均不显著。"家乡票"效应在统计上无法与行业性粉丝团(社交媒体粉丝、乡村音乐粉丝)的效应相区分。
7.4 评委分与粉丝支持的联合分布
Hexbin 联合密度图(论文 Figure 11)的核心区域(最暗六边形)对应 且 的大概率区域——反映了比赛历史上专业评审与观众偏好的典型耦合模式。离群值的分布模式揭示了两类异常:(i) 高评委分 + 低粉丝支持 = "未被观众认可的技术流",(ii) 低评委分 + 高粉丝支持 = "技术粗糙但极受欢迎的娱乐型选手"。
8. Task 5: 机制设计优化
8.1 问题形式化
定义广义投票机制的组合指标为评委分与粉丝票的加权和:
其中 分别为归一化(百分比)评委分与粉丝票, 为评委权重。 对应传统的 50/50 Percentage 法; 偏向纯评委决策; 偏向纯粉丝决策。
定义两个竞争性的优化目标:
定义 8 (False Elimination Rate, FER). 评委分 Top 3 的选手被淘汰的概率:
理想目标:。
定义 9 (Retention Rate, RR). 粉丝人气 Top 3 的选手存活的概率:
理想目标:。
8.2 多目标网格搜索
在历史数据上以步长 遍历 ,计算每个 下的 FER 和 RR。结果(论文 Figure 12):
- (更好 meritocracy)但 (有丢失粉丝最爱的风险)
- (更好 retention)但 (产生技术惨案)
- Pareto 前沿上的静态最优解位于
8.3 Dynamic Phase-Shift 策略
单个静态权重在赛季全程上并非最优——赛季早期与晚期的目标函数存在本质差异。因此提出分阶段动态策略:
| 阶段 | 周数 | 评委权重 | 粉丝权重 | 机制目标 |
|---|---|---|---|---|
| Phase 1 (Engagement) | Week 1–8 | 0.10 | 0.90 | 最大化观众留存,保护多样化选手角色 |
| Phase 2 (Championship) | Week 9–决赛 | 0.45 | 0.55 | 向 meritocracy 倾斜,确保冠军技术含金量 |
| Technical Safety Net | 全赛季 | — | — | 若 Top 3 技术分选手落入 Bottom 3,触发评委拯救 |
Safety Net 规则的形式化定义:
定义 10 (Technical Safety Net). 设 为技术前三。按 Eq. (22) 计算 后,设 为 Bottom 3。若 ,则评委从 中淘汰一位非技术前三的选手(评委分最低者)。此规则确保技术顶尖选手不会被投票淘汰。
8.4 性能对比
| 机制 | FER | RR | 综合效用 |
|---|---|---|---|
| Static 50/50 | 基准 | ||
| Static 45/55 | Pareto 最优静态点 | ||
| Dynamic + Safety Net | 0.0% | 91.8% | 双目标同时改善 |
动态方案本质上消除了"技术惨案"(如 Sabrina Bryan 类案例),同时保持了较高的观众参与度。FER 从 意味着在历史回溯测试中,没有任何一位技术 Top 3 的选手被提前淘汰。RR 从 意味着最受欢迎的选手几乎全部进入了决赛轮。
9. 备忘录 (Memorandum)
To: Producers of Dancing with the Stars
From: Team 2613579
Date: February 2, 2026
Subject: Analysis of Voting Mechanisms and Recommendations for Future Seasons
Executive Summary
我们对 34 季 Dancing with the Stars 数据进行了综合分析。贝叶斯 MCMC 模型以 98.5% 的可行率再现了历史淘汰结果,Rank 与 Percentage 聚合函数的系统性比较揭示了两种机制在公平性维度上的结构性差异,并基于多目标优化提出了一种动态分阶段投票策略。
Key Findings
1. 粉丝救援阈值。 当选手的 Relative Popularity Index (Z-score) > 1.0 时,低评委分几乎不会导致淘汰。粉丝支持是淘汰决策中的决定性安全网。
2. 投票机制的本质差异。
- Percentage-Based — 核心:。结构性偏向极化粉丝团体,允许争议性冠军(Bobby Bones 类案例)。
- Rank-Based — 核心:。排名压缩贬低估评高分,对温和离群值有效,但对超级粉丝多数约束不足。
- Judge-Save — 核心:Bottom 2 评委投票。仅在选手实际落入 Bottom 2 时触发,对 Billy Ray Cyrus 类案例高效,对 Bobby Bones 类案例完全无效。
3. 评委与粉丝偏好的系统性分歧。
| 因素 | 评委偏好 | 粉丝偏好 | 分歧特征 |
|---|---|---|---|
| 年龄 | 线性递减 (, ) | 三次 U 形 (峰值 49.7 岁) | 粉丝给予 60+ 岁"怀旧溢价" |
| 社交媒体红人 | () | 粉丝优势 = 技术优势 | |
| 舞伴 | 技术专家显著正面 | 仅弱相关 () | 技术不等于人气 |
Recommendations
- Phase 1 (Week 1–8): (10% 评委 / 90% 粉丝),最大化观众参与
- Phase 2 (Week 9–Finals): (45% 评委 / 55% 粉丝),确保冠军技术水准
- Technical Safety Net: Top 3 技术分选手落入 Bottom 3 时自动触发评委拯救
预期效果: False Elimination Rate 从 ;Retention Rate 提升至 ,两项指标均超过任何静态权重分割。
Implementation Steps
- 使用历史数据验证策略与预期结果的一致性
- 根据赛季总周数调整阶段转换点(建议第 9 周)
- 向观众与评委清晰传达新规则以保障透明度
Sincerely,
Team 2613579
10. 方法论反思
10.1 假设与局限
局限 1: 逆推的唯一性。 对许多淘汰周次,粉丝票的可行解区域并非单点——不同粉丝分布可产生相同淘汰结果。后验方差 量化了此不确定性。Rank 模式下约束较紧( 较小),Percentage 模式下可行域更宽。
局限 2: Season 28+ 的 Judge Save。 批量 MCMC 重构中假设淘汰者 = 最低组合分者,这忽略了 Judge Save 中 Bottom 2 + 评委投票的机制。对此,我们在 Section 6 进行了独立的逐案例反事实模拟作为补充。
局限 3: Dirichlet 的独立同分布假设。 Dirichlet 分布假设 各分量满足负相关约束 ,但未显式建模粉丝之间的"转移"现象(某选手淘汰后,其粉丝可能系统性转向特定选手)。
局限 4: 舞伴选择偏差。 OLS 回归中的舞伴系数包含不可忽略的选择偏差——高知名度舞伴更可能被分配给高潜力明星。我们报告的系数应解读为关联性而非因果性。
10.2 技术启示
Informative Prior 的本质性作用。 平坦 Dirichlet 先验 () 下可行率仅约 60%。引入 Eq. (6) 的序贯贝叶斯更新使可行率跃升至 98.5%。这说明了高维隐变量推断中的一条原则:在先验信息极度匮乏时,均匀采样几乎无法命中与约束一致的区域。通过时序结构注入 Informative Prior 将推断从不可能变为可能。
反事实模拟对直觉的修正。 Bobby Bones 案例是最具方法论启发性的发现。普遍舆论认为"恢复 Rank 法即可防止 Bobby Bones 问题",但形式化模拟表明 Eq. (3) 在 时 ,当其他选手排名分散时并非必然最大。形式化建模在此纠正了一个广泛共享的错误直觉。
附录:项目文件结构
1 | D:/MCMICM/ |
本文基于 2026 MCM/ICM Problem C (Team 2613579) 的全部工作文件撰写。所有公式编号、Table/Figure 引用、数据数值(98.5%, 91.8%, 0.0%, , , 等)均与提交的 25 页 PDF 论文原文一致。
竞赛时间:2026 年 1 月 29 日 – 2 月 2 日
完整论文
- Title: Analysis and Optimization of Voting Mechanisms for Dancing with the Stars
- Author: 椿咲璃音
- Created at : 2026-02-02 01:37:00
- Updated at : 2026-08-10 16:32:14
- Link: https://jackerytu.github.io/2026/02/02/2026MCM_C/
- License: This work is licensed under CC BY-NC-SA 4.0.