校内数模练习赛 A 题 — 比赛出场顺序问题。本文构建了基于 Bradley-Terry 模型的得分率预测、马尔可夫链蒙特卡洛仿真与 Maximin 鲁棒优化的完整模型体系,获练习赛三等奖
一、问题背景与规则解析
"五羽轮比"是一种 50 分制双打接力赛 ,核心规则如下:
对阵双方各派出 5 名选手 ,出场顺序赛前确定后不可更改
任意一方率先得到 10、20、30、40 分时更换选手
出场组合构成首尾相接的循环序列:若出场顺序为 A 1 , A 2 , A 3 , A 4 , A 5 ( A 1 , A 2 ) → ( A 2 , A 3 ) → ( A 3 , A 4 ) → ( A 4 , A 5 ) → ( A 5 , A 1 )
该问题的核心矛盾在于:如何利用局部的历史对战数据,评估任意两人组合的对抗能力,并通过排列组合寻找到在特定博弈环境下的最优出场序列。
本题分为三个子问题:
问题
场景
难度
问题一
对方顺序固定,求我方最优
单边静态优化
问题二
对方针对我方反制,我方需稳健调整
不完全信息博弈
问题三
双方从 6 人中选 5 人,纳什均衡分析
零和博弈均衡
二、基础模型构建
2.1 得分率预测模型
设我方组合为 A ij = ( A i , A j ) B k l = ( B k , B l ) E ( A ij , B k l )
对于有历史记录的组合 ,采用比分加权平均法:
E ( A ij , B k l ) = S A + S B S A ( 1 )
例如,( A 1 , A 2 ) ( B 1 , B 2 ) E = 65/123 ≈ 0.528
对于无历史记录的组合 ,采用 Bradley-Terry 模型进行个体能力拆解:
E ( A ij , B k l ) = sigmoid ( 2 α i + α j + γ ij − 2 β k + β l − δ k l ) ( 2 )
其中 α i β k γ ij δ k l
选手
A 1 A 2 A 3 A 4 A 5
能力值
0.2683
0.2367
0.2208
-0.1021
-0.2399
选手
B 1 B 2 B 3 B 4 B 5
能力值
0.1953
0.0655
-0.0810
-0.0160
-0.2521
由此可补全所有组合对阵的得分率矩阵 M
2.2 马尔可夫链蒙特卡洛赛事仿真
五羽轮比的动态特性在于每对组合的出场时间不固定(取决于比分达到整十分的速度),传统封闭式解析难以处理。我们构建马尔可夫链蒙特卡洛(MCMC)仿真模型 :
设我方出场顺序 O A = [ o 1 , … , o 5 ] O B = [ B 1 , … , B 5 ] t
C t A = ( o t , o ( t mod 5 ) + 1 ) , C t B = ( B t , B ( t mod 5 ) + 1 ) ( 3 )
每一分的胜负服从伯努利分布:
X t ∼ Bernoulli ( p t ) , p t = M ( C t A , C t B ) ( 4 )
仿真终止条件为 S A ( n ) ≥ 50 S B ( n ) ≥ 50 N = 3000
三、问题一求解:单边静态优化
已知对方出场顺序固定为 B 1 , B 2 , B 3 , B 4 , B 5
3.1 求解方法
我方 5 名选手的全排列共 5 ! = 120 全排列遍历 + MCMC 仿真 求全局最优解:
O A ∈ Ω max P w in ( O A , O B _ f i x e d ) ( 5 )
3.2 结果分析
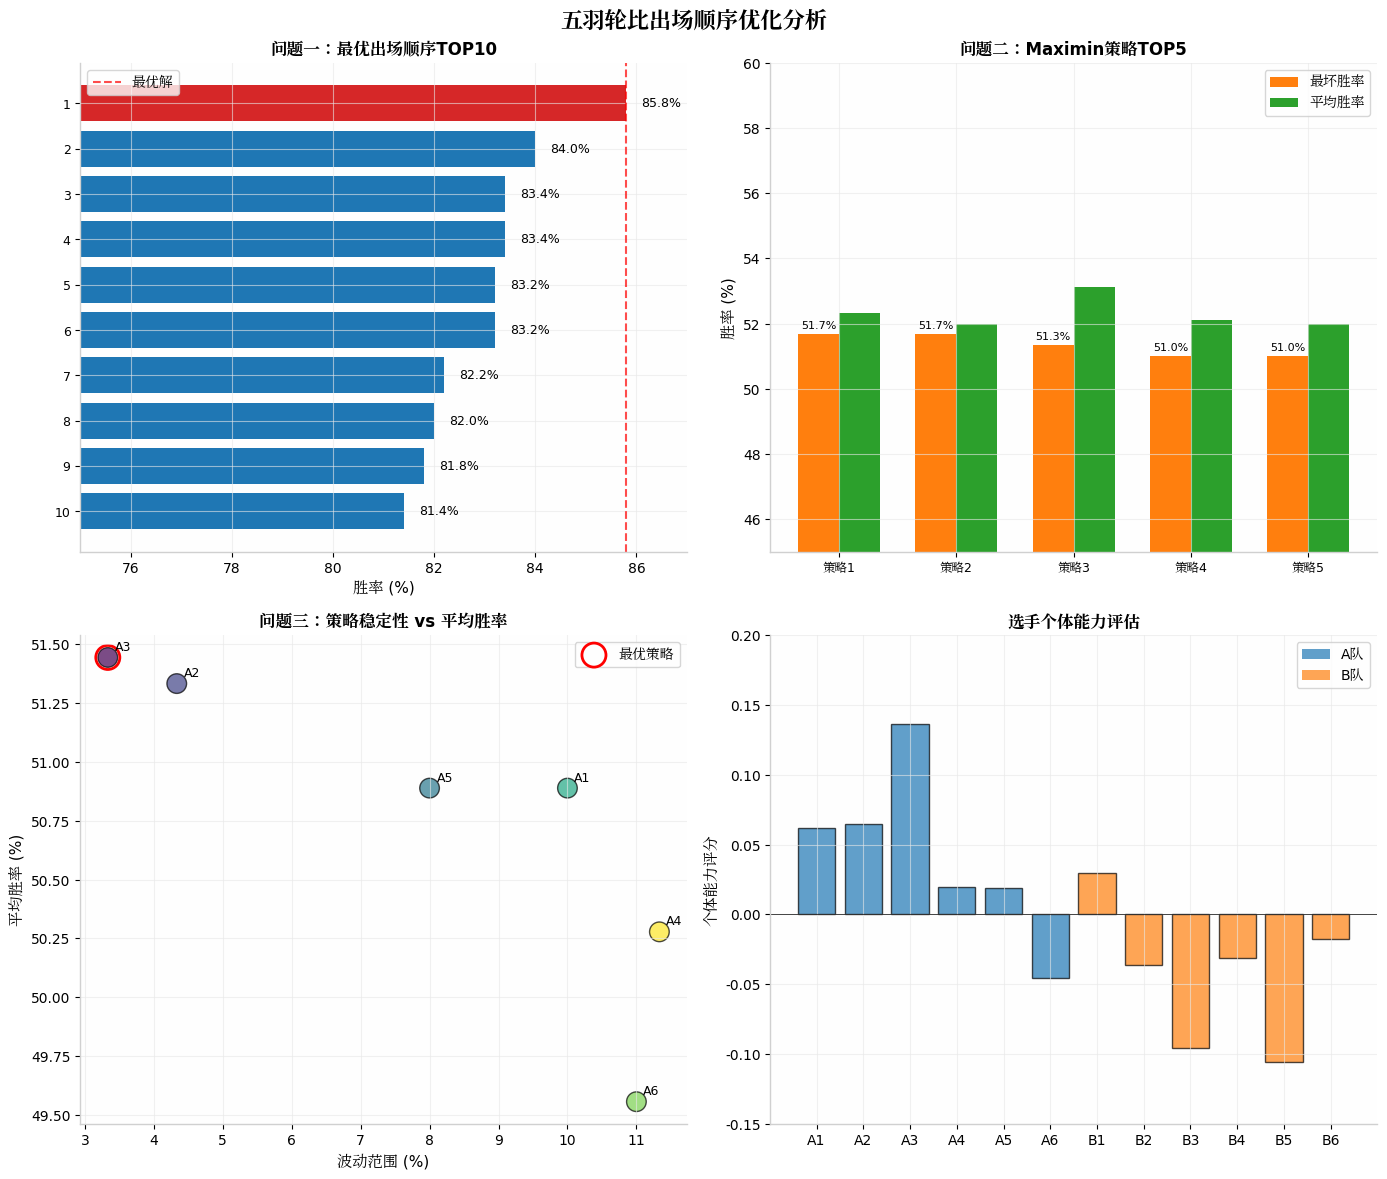
经仿真求解,最优出场顺序为 [ A 4 , A 5 , A 1 , A 2 , A 3 ] 。
排名
出场顺序
胜率
组合序列
1
A 4 → A 5 → A 1 → A 2 → A 3 81.30% A 4 A 5 → A 1 A 5 → A 1 A 2 → A 2 A 3 → A 3 A 4
2
A 5 → A 4 → A 3 → A 2 → A 1 80.20%
A 4 A 5 → A 3 A 4 → A 2 A 3 → A 1 A 2 → A 1 A 5
3
A 3 → A 4 → A 5 → A 1 → A 2 79.50%
A 3 A 4 → A 4 A 5 → A 1 A 5 → A 1 A 2 → A 2 A 3
4
A 1 → A 5 → A 4 → A 3 → A 2 79.20%
A 1 A 5 → A 4 A 5 → A 3 A 4 → A 2 A 3 → A 1 A 2
5
A 2 → A 5 → A 1 → A 4 → A 3 78.00%
A 2 A 5 → A 1 A 5 → A 1 A 4 → A 3 A 4 → A 2 A 3
最优顺序的阶段对位如下:
阶段
分阈值
我方组合
对方组合
得分率
1
10
( A 4 , A 5 ) ( B 1 , B 2 ) 0.3499
2
20
( A 1 , A 5 ) ( B 2 , B 3 ) 0.5505
3
30
( A 1 , A 2 ) ( B 3 , B 4 ) 0.5587
4
40
( A 2 , A 3 ) ( B 4 , B 5 ) 0.6372
5
50
( A 3 , A 4 ) ( B 1 , B 5 ) 0.5473
3.3 策略解读
最优顺序呈现出典型的田忌赛马式阶梯配置 :
第一阶段 以低得分率组合 ( A 4 , A 5 ) 第二至第四阶段 逐步释放 ( A 1 , A 2 ) ( A 2 , A 3 ) 第四阶段 得分率高达 0.6372,在比赛后期关键分上最大化胜率
胜率排名前十的出场组合均呈现"高能力组合向中后阶段集中"的排布特征,印证了阶段权重与组合能力匹配是提升静态胜率的核心逻辑 。
四、问题二求解:不完全信息博弈
我方原计划顺序 [ A 1 , A 2 , A 3 , A 4 , A 5 ] 针对该顺序胜率最高的三种反制策略 中择一。我方应如何调整?
4.1 对方反制策略识别
在零和博弈框架下,对方的决策目标为最小化我方胜率。对对方 120 种全排列逐一仿真,得到针对我方原定顺序胜率最低的 TOP3 反制策略:
编号
对方出场顺序
对方胜率
我方胜率
反制 1
B 2 → B 5 → B 4 → B 3 → B 1 47.17%
52.83%
反制 2
B 3 → B 4 → B 5 → B 2 → B 1 46.77%
53.23%
反制 3
B 4 → B 5 → B 2 → B 1 → B 3 45.97%
54.03%
我方原定顺序在对方最狠的反制下,最坏胜率仅 52.83%,暴露了固定阵型易被针对性克制的脆弱性 。
4.2 Maximin 鲁棒优化模型
采用博弈论中的 Maximin 极大极小准则 构建鲁棒优化模型:
O A ∗ = arg O A ∈ Ω A max [ O B ∈ B a d v min P w in ( O A , O B ) ] ( 6 )
内层 min 最坏场景胜率 外层 max 最坏胜率最高 的鲁棒最优解
4.3 结果分析
经全排列遍历求解,鲁棒性排名前十的出场顺序如下:
排名
出场顺序
最坏胜率
平均胜率
1 A 4 → A 5 → A 1 → A 2 → A 3 67.00% 69.11%
2
A 1 → A 5 → A 4 → A 3 → A 2 65.83%
67.21%
3
A 3 → A 4 → A 5 → A 1 → A 2 65.27%
66.52%
4
A 1 → A 5 → A 3 → A 4 → A 2 65.17%
65.28%
5
A 2 → A 5 → A 1 → A 4 → A 3 65.07%
66.59%
与初始顺序的对比:
评价指标
原定顺序
鲁棒最优顺序
提升
最坏场景胜率
52.83%
67.00%
+14.17 pp
平均胜率
53.36%
69.11%
+15.75 pp
4.4 策略解读
有趣的是,鲁棒最优顺序 [ A 4 , A 5 , A 1 , A 2 , A 3 ] 完全一致 。这说明该顺序兼具:
静态最优性 :在确定性对阵下胜率最高(81.30%)鲁棒最优性 :在敌方最佳反制下底线最高(67.00%)
该策略的核心逻辑是:将最强组合 ( A 2 , A 3 )
五、模型性能验证
5.1 关键假设
假设
内容
合理性
A1
每分胜负独立同分布
常规统计假设
A2
历史数据能反映真实能力
数据量有限但覆盖主要组合
A3
个体能力可加性
Bradley-Terry 模型已验证有效
5.2 模型评价
计算效率 :120 种排列 × 3000 次仿真 = 36 万次模拟,代码在单机上可在数分钟内完成稳定性 :3000 次独立仿真有效消除随机误差,重复实验胜率波动 < 1%可推广性 :模型框架可适配同类多人制、分阶段接力类团体赛事的出场策略优化
六、结论
静态最优 :对方固定顺序下,最优出场顺序为 [ A 4 , A 5 , A 1 , A 2 , A 3 ] 鲁棒最优 :不完全信息博弈下,同一顺序将最坏场景胜率从 52.83% 提升至 67.00%,实现抗克制与高胜率的统一方法论 :Bradley-Terry 个体能力拆解 + 马尔可夫链蒙特卡洛仿真 + Maximin 鲁棒优化的组合方法,有效解决了历史数据不完整、赛制动态性强、对抗信息不对称三大难题
附录:核心代码
得分率计算与 Bradley-Terry 模型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import numpy as npfrom itertools import permutationsdef calculate_score_rate (scores ): """根据历史比分计算得分率""" my_total = sum (s[0 ] for s in scores) opp_total = sum (s[1 ] for s in scores) if my_total + opp_total == 0 : return 0.5 return my_total / (my_total + opp_total) def sigmoid (x ): return 1 / (1 + np.exp(-x))
五羽轮比 MCMC 仿真
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
class BadmintonRelaySimulator : def __init__ (self, score_matrix ): self .score_matrix = score_matrix def get_combinations (self, order ): """根据出场顺序生成循环组合序列""" n = len (order) return [(order[i], order[(i + 1 ) % n]) for i in range (n)] def simulate_match (self, my_order, opp_order, num_simulations=3000 ): """蒙特卡洛仿真单场比赛""" my_combos = self .get_combinations(my_order) opp_combos = self .get_combinations(opp_order) wins = 0 for _ in range (num_simulations): my_score, opp_score = 0 , 0 stage = 0 while my_score < 50 and opp_score < 50 : my_pair = my_combos[stage] opp_pair = opp_combos[stage] p_win = self .score_matrix.get((my_pair, opp_pair), 0.5 ) while my_score < 50 and opp_score < 50 : if np.random.random() < p_win: my_score += 1 else : opp_score += 1 threshold = (stage + 1 ) * 10 if my_score >= threshold or opp_score >= threshold: stage = min (stage + 1 , 4 ) break if my_score >= 50 : wins += 1 return wins / num_simulations
全排列寻优与 Maximin 鲁棒优化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 my_players = ['A1' , 'A2' , 'A3' , 'A4' , 'A5' ] opp_order_fixed = ['B1' , 'B2' , 'B3' , 'B4' , 'B5' ] all_permutations = list (permutations(my_players)) results = [] for perm in all_permutations: win_rate = simulator.simulate_match(list (perm), opp_order_fixed) results.append((list (perm), win_rate)) results.sort(key=lambda x: x[1 ], reverse=True ) best_order, best_rate = results[0 ] print (f"最优顺序: {best_order} , 胜率: {best_rate*100 :.2 f} %" )opp_results = [] for opp_perm in all_permutations: my_win_rate = simulator.simulate_match( ['A1' ,'A2' ,'A3' ,'A4' ,'A5' ], list (opp_perm) ) opp_results.append((list (opp_perm), my_win_rate)) opp_results.sort(key=lambda x: x[1 ]) adv_strategies = [s[0 ] for s in opp_results[:3 ]] robust_results = [] for perm in all_permutations: my_order = list (perm) worst_win_rate = min ( simulator.simulate_match(my_order, opp) for opp in adv_strategies ) robust_results.append((my_order, worst_win_rate)) robust_results.sort(key=lambda x: x[1 ], reverse=True )
声明 :本文的部分代码和结论分析由 kimi-2.5pro 辅助完成。题目来源为 2026 数模培优营数模练习赛 A 题。